简介
一、基础定位
Spark是Apache独立顶级项目,不属于Hadoop组件。
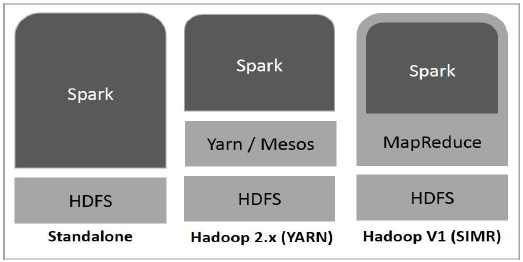
可以复用Hadoop生态:读HDFS存储,跑在YARN做资源调度;也可以完全脱离Hadoop独立运行。
内核由Scala编写;对外提供 Scala / Java / PySpark(Python) / R API。
核心抽象:RDD(弹性分布式数据集)。
安装
下载官网:https://spark.apache.org/downloads.html
切换 home 目录并下载 spark-4.2.0
cd ~/ && wget https://dlcdn.apache.org/spark/spark-4.2.0/spark-4.2.0-bin-hadoop3.tgz
解压
tar -zxvf spark-4.2.0-bin-hadoop3.tgz
mv -f spark-4.2.0-bin-hadoop3 ~/spark
配置环境变量,打开 .bashrc
nvim ~/.bashrc
添加
export SPARK_HOME=/home/hadoop/spark
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin
生效
source ~/.bashrc
验证
spark-shell
打开 spark-env.sh 进行配置
cd $SPARK_HOME/conf
cp spark-env.sh.template spark-env.sh
nvim spark‑env.sh
添加如下,其中 JAVA_HOME、HADOOP_HOME 为本机真实路径
export JAVA_HOME=/usr/lib/jvm/java‑17‑openjdk‑arm64

export HADOOP_CONF_DIR=$HADOOP_HOME/etc/hadoop

export YARN_CONF_DIR=$HADOOP_HOME/etc/hadoop

export SPARK_DIST_CLASSPATH=$($HADOOP_HOME/bin/hadoop classpath)
关闭 yarn 内存检测
nvim yarn-site.xml
写入
<property>
    <name>yarn.nodemanager.pmem‑check‑enabled</name>
    <value>false</value>
</property>
<property>
    <name>yarn.nodemanager.vmem‑check‑enabled</name>
    <value>false</value>
</property>
启动 start-dfs.sh、start-yarn.sh
测试运行
pyspark --master yarn
运行 python 并输入
rdd = sc.textFile("/user/hadoop/mr/input/test.txt")
rdd.count()
exit()
打开 wc.py
nvim wc.py
写入
from pyspark import SparkContext
sc = SparkContext(appName="test_wc")
rdd = sc.textFile("/user/hadoop/mr/input/test.txt")
res = rdd.flatMap(lambda l:l.split(" ")).map(lambda w:(w,1)).reduceByKey(lambda a,b:a+b)
hdfs dfs -rm -r /user/hadoop/spark_out
res.saveAsTextFile("/user/hadoop/spark_out")
sc.stop()
提交命令
hdfs dfs -rm -r /user/hadoop/spark_out
spark-submit --master yarn --executor‑memory 1g wc.py
访问 spark 网页
http://localhost:4040
访问 yarn 网页
http://localhost:8088